[업무 이해] APM이란?
- APM이란?
- APM은 왜 필요할까?
- APM에서 확인할 수 있는 정보
- Trace란?
- APM과 Log의 차이
- APM을 이용한 장애 확인 흐름
- 대표적인 APM Tool
- 내가 사용해본 APM
- 용어 정리
- Datadog 대시보드 구축 시 주의할 점
- 참고 자료
- 마치며
APM이란?
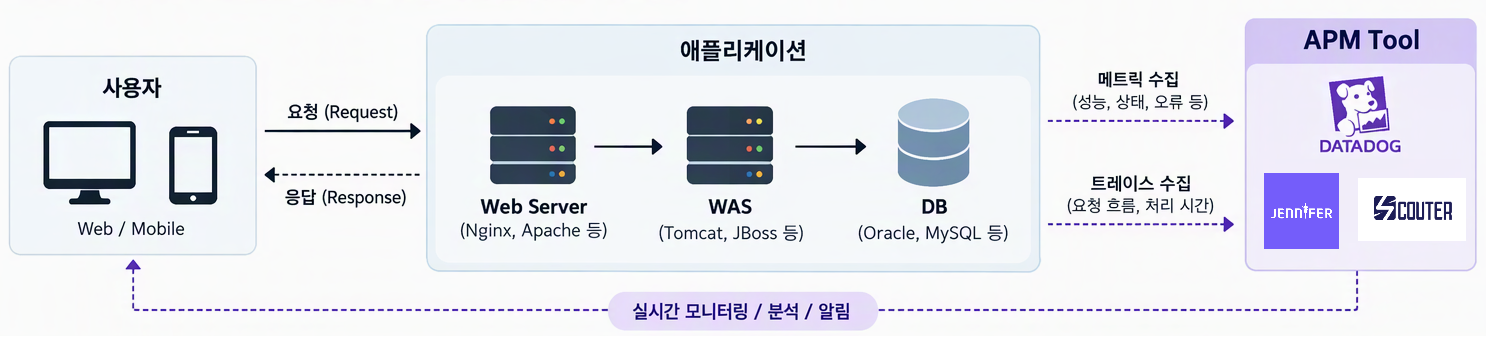
- APM(Application Performance Monitoring)은 애플리케이션의 성능과 상태를 모니터링하고 관리하기 위한 Tool이다.
- 서비스의 요청 건수, 응답 시간, 오류, CPU 및 Memory 사용량 등을 확인할 수 있다.
- 문제가 발생하면 어떤 요청과 구간에서 지연 또는 오류가 발생했는지 추적하는 데 도움을 준다.
- 대표적인 APM Tool로는 Datadog, Jennifer, Scouter 등이 있다.
APM은 왜 필요할까?
- 사용자의 요청은 Web Server, WAS, DB 등 여러 구간을 거쳐 처리된다.
- 서비스가 느려졌을 때 화면만 보고는 어느 구간에서 문제가 발생했는지 알기 어렵다.
- APM을 사용하면 다음과 같은 문제를 확인할 수 있다.
- 특정 API의 처리 지연
- DB Query의 처리 지연
- WAS의 CPU 또는 Memory 부족
- 외부 API 호출 지연
- 애플리케이션 오류 발생
- 이를 통해 장애 발생 지점을 빠르게 찾고 서비스 상태를 지속적으로 관리할 수 있다.
APM에서 확인할 수 있는 정보
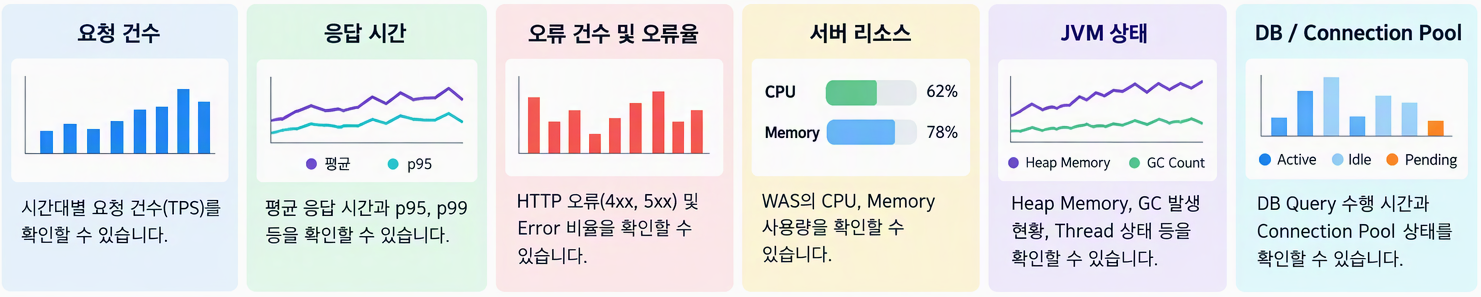
요청 건수
- 일정 시간 동안 애플리케이션이 처리한 요청 수를 확인할 수 있다.
- TPS(Transaction Per Second)는 1초 동안 처리한 Transaction 수를 의미한다.
- 여러 대의 WAS를 운영한다면 요청이 각 WAS에 적절히 분배되는지도 확인할 수 있다.
응답 시간
- 사용자의 요청이 처리되기까지 걸린 시간을 확인할 수 있다.
- 평균 응답 시간뿐 아니라 p95, p99와 같은 값을 함께 확인하기도 한다.
- 예를 들어 p95가 2초라면 전체 요청의 약 95%가 2초 이내에 처리되었다는 의미이다.
오류 건수
- HTTP Status Code 또는 Exception을 기준으로 오류를 확인할 수 있다.
- 일반적으로 4xx는 Client 요청 문제, 5xx는 Server 처리 문제를 의미한다.
- HTTP Status Code가 200이어도 내부적으로 오류가 발생할 수 있으므로 Trace와 Log를 함께 확인해야 한다.
Server Resource
- WAS가 동작하는 서버의 CPU와 Memory 사용량을 확인할 수 있다.
- 특정 WAS에만 부하가 집중되거나 Memory 사용량이 계속 증가하는 상황을 찾을 수 있다.
- 현재 값뿐 아니라 일정 시간 동안의 변화도 함께 확인해야 한다.
JVM 상태
- Java 애플리케이션에서는 Heap Memory, Garbage Collection, Thread 상태 등을 확인할 수 있다.
- GC가 자주 발생하거나 수행 시간이 길어지면 응답 시간이 느려질 수 있다.
- 사용 가능한 Thread가 부족한 경우에도 요청 처리가 지연될 수 있다.
DB 및 Connection Pool
- DB Query의 수행 시간과 호출 횟수를 확인할 수 있다.
- HikariCP와 같은 Connection Pool을 사용한다면 Active, Idle, Pending Connection도 확인할 수 있다.
- Pending Connection이 증가하면 DB Connection을 얻지 못한 요청이 대기하고 있을 가능성이 있다.
Trace란?
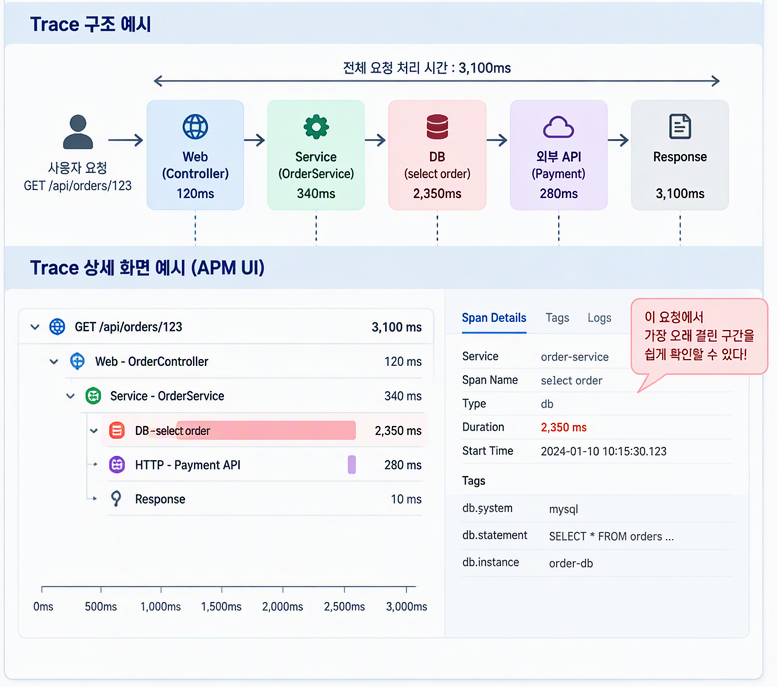
- Trace는 하나의 요청이 애플리케이션 내부에서 처리된 과정을 보여준다.
- 하나의 Trace는 여러 개의 Span으로 구성된다.
- Span은 Web 요청, Method 실행, DB Query, 외부 API 호출과 같은 개별 작업을 의미한다.
- Trace를 확인하면 어느 작업에서 시간이 오래 걸렸는지 또는 오류가 발생했는지 찾을 수 있다.
APM과 Log의 차이
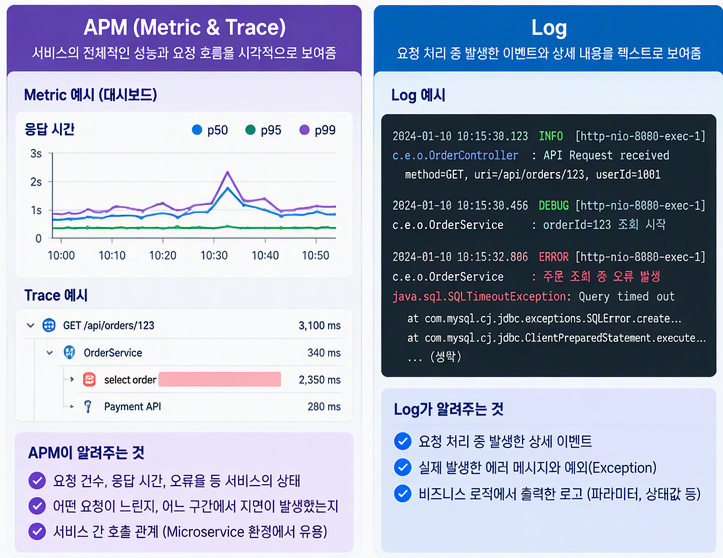
- Metric은 요청 건수, 응답 시간, 오류율과 같은 서비스의 전체적인 상태를 보여준다.
- Trace는 하나의 요청이 처리된 과정과 구간별 처리 시간을 보여준다.
- Log는 요청 처리 중 발생한 Message와 Exception을 자세히 보여준다.
- 일반적으로 Metric에서 이상 징후를 발견하고, Trace와 Log를 이용해 원인을 찾는다.
APM을 이용한 장애 확인 흐름
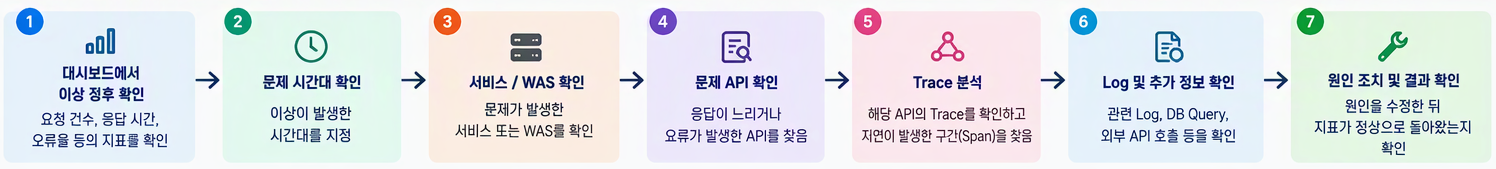
- Dashboard에서 요청 건수, 응답 시간, 오류율을 확인한다.
- 문제가 발생한 시간대와 Service를 확인한다.
- 응답이 느리거나 오류가 발생한 API를 찾는다.
- 해당 API의 Trace를 확인한다.
- 처리 시간이 긴 Span 또는 오류가 발생한 Span을 찾는다.
- 관련 Log와 DB Query를 확인한다.
- 조치 후 지표가 정상으로 돌아왔는지 확인한다.
대표적인 APM Tool
Datadog
- Datadog은 APM, Infrastructure, Log 등 다양한 모니터링 기능을 제공하는 Observability Platform이다.
- APM과 서버의 CPU, Memory, JVM 정보를 하나의 Dashboard에서 확인할 수 있다.
- 기능이 다양한 만큼 Metric, Tag, 집계 방식에 대한 이해가 필요하다.
Jennifer
- Jennifer는 국내에서 개발된 상용 APM Solution이다.
- Java와 .NET 애플리케이션의 Transaction Monitoring과 장애 분석 기능을 제공한다.
- 상용 Solution이기 때문에 License 비용이 발생하지만 기술 지원을 받을 수 있다.
Scouter
- Scouter는 Open Source APM Tool이다.
- XLog를 통해 Transaction의 응답 시간과 분포를 직관적으로 확인할 수 있다.
- TPS, Active Service, CPU, Memory, Heap Memory 등의 정보도 함께 제공한다.
- License 비용 부담은 적지만 설치와 운영을 직접 관리해야 한다.
내가 사용해본 APM
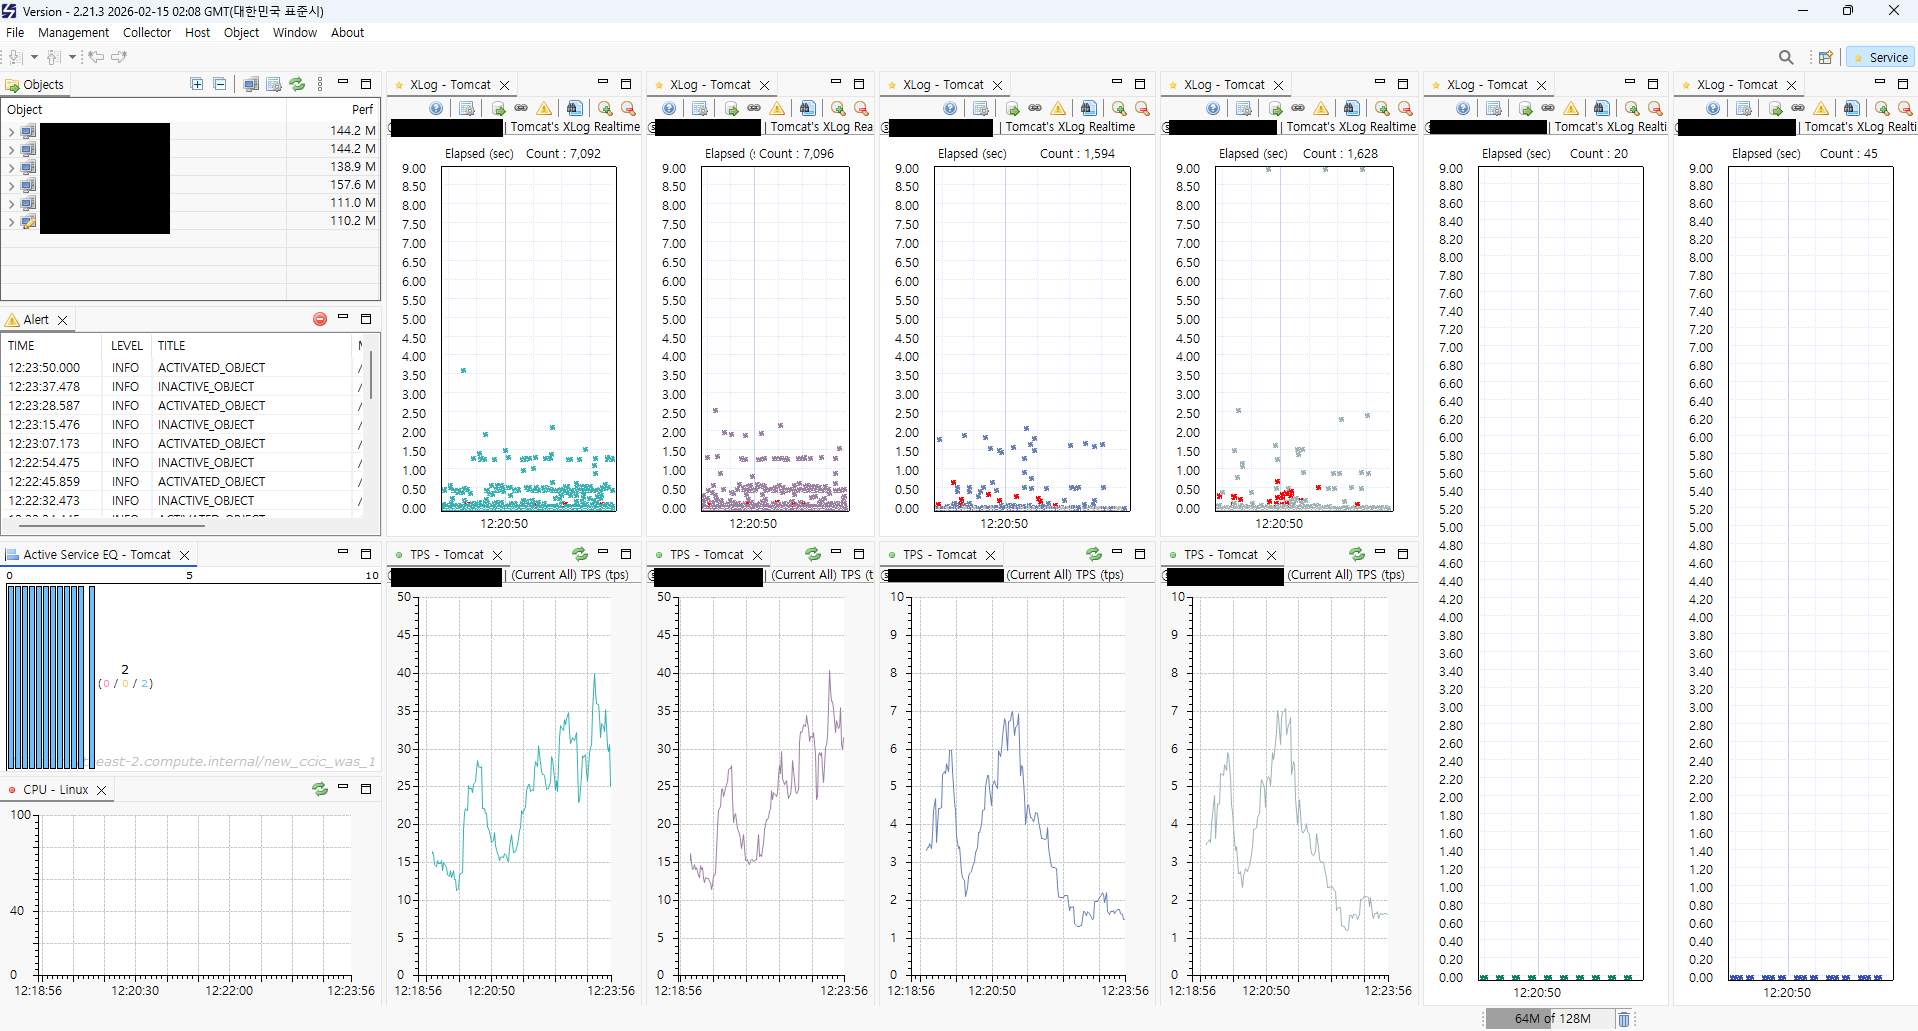
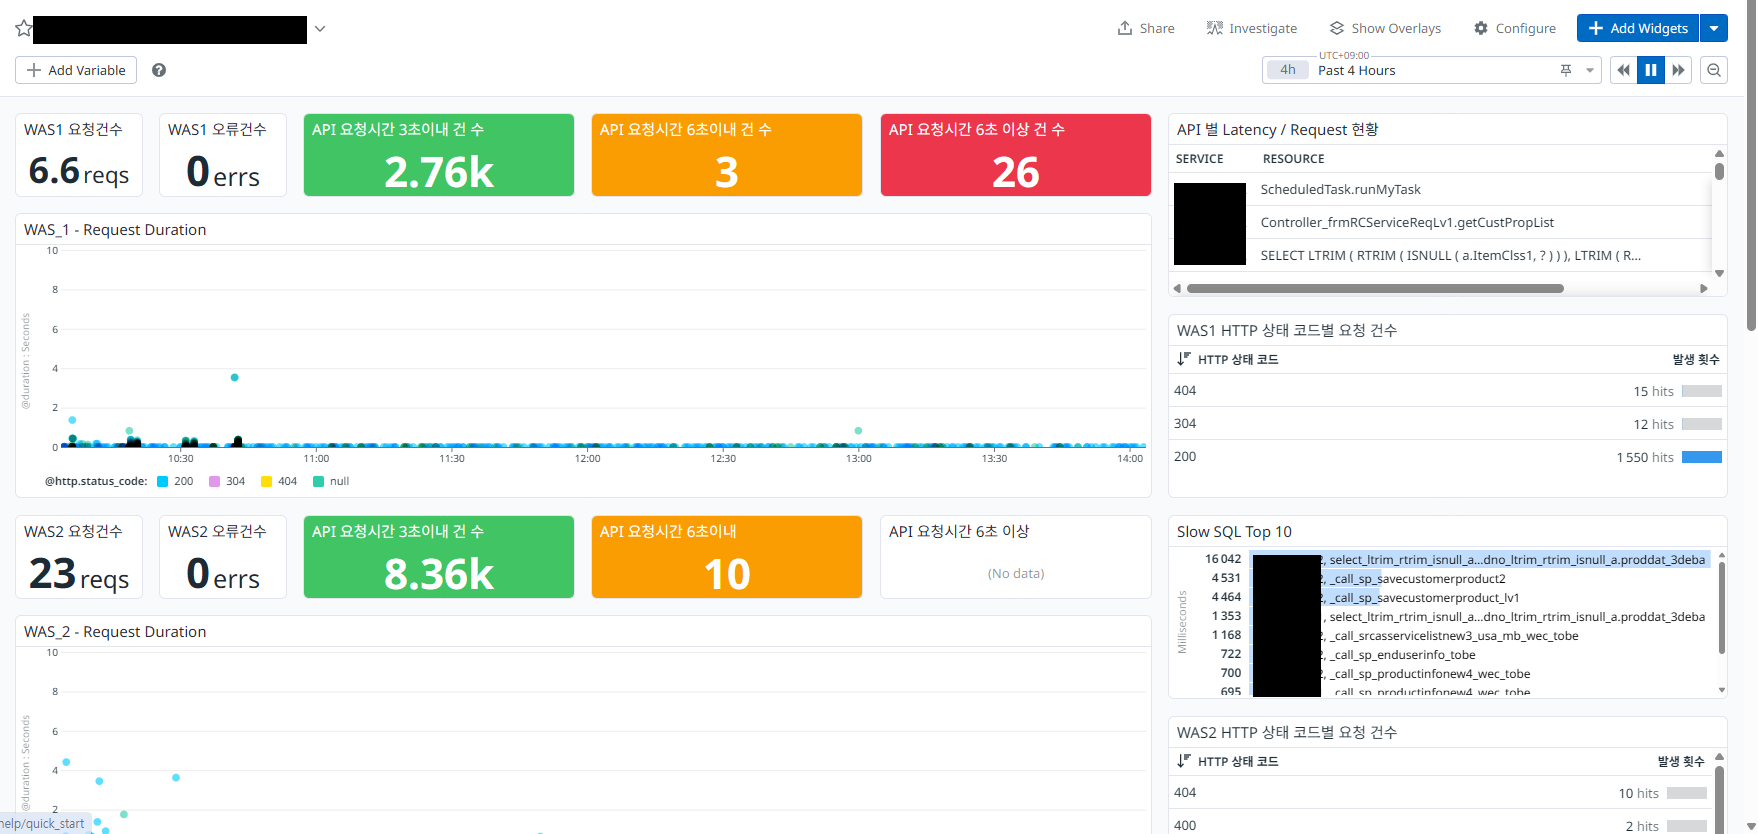
- 나는 Scouter와 Datadog을 이용하여 WAS와 애플리케이션의 상태를 모니터링 했다.
- Scouter에서 Datadog로 마이그레이션 작업을 수행하며 Scouter의 장점을 가져가되 Datadog의 장점도 보장해야 했다.
Scouter에서는 XLog를 통해 느린 Transaction과 오류가 발생한 Transaction을 직관적으로 확인할 수 있었고, Datadog에서는 요청 건수, 응답 시간, 오류 건수 등을 커스텀하여 직관적으로 보여줄 수 있었다.
- 나는 XLog를 Request duration point plot으로 구성했고, 요청건수, 오류건수, Slow 쿼리, API 현황 등을 배치해서 담당자가 운영에 있어 손쉽게 모니터링 할 수 있도록 구성했다.
Datadog은 원하는 정보를 자유롭게 배치할 수 있지만 Metric과 Tag의 의미를 이해해야 정확한 Dashboard를 만들 수 있었다.
용어 정리
| 용어 | 내용 |
|---|---|
| XLog | 전체 Transaction(HTTP 요청, Batch 작업 등)의 응답 시간 분포와 Profiling 정보를 한눈에 파악할 수 있는 핵심 성능 Log 및 산점도(Scatter) Chart |
| Elapsed Time | 평균 응답 시간 |
| Elapsed Time 90% | 이상값(너무 크거나 작은 값)을 제외한 평균 응답 시간 |
| GC Time | Garbage Collection 작업 수행 시간 - 1초를 넘지 않도록 관리해야 하며, 길어지면 사용자 응답 시간이 느려지고 CPU 사용량이 급증할 수 있다. - Heap Memory가 부족하거나 Memory Leak이 발생하면 GC Count 및 GC Time이 상승할 수 있다. |
| Heap Used | 실제 사용하고 있는 Heap Memory 크기 |
| Heap Memory | 할당된 전체 Heap Memory 크기 및 사용 현황 |
| Recent User | 최근 5분 동안(시간 조정 가능) 1번 이상 요청을 보낸 고유 사용자 수 |
퍼센타일 지표(p50, p75, p90, p95, p99)
- 퍼센타일(백분위수)은 데이터를 작은 값부터 정렬했을 때 특정 비율에 해당하는 지점의 값이다.
- 예를 들어 응답 시간의 p95가 500ms라면 전체 요청의 95%가 500ms 이하로 처리되고, 나머지 5%가 500ms를 초과했다는 의미이다.
| 백분위수 | 명칭 | 용어 의미 및 설명 | 시스템 및 성능 데이터 분석 관점의 의미 |
|---|---|---|---|
| p50 | 중앙값 | 데이터를 작은 값부터 정렬했을 때 50% 위치에 있는 값 | 전체 요청의 50%가 해당 값 이하로 처리되었음을 의미한다. 사용자 절반이 경험하는 일반적인 응답 시간을 파악할 때 사용한다. 예를 들어 p50이 100ms라면 전체 요청의 50%가 100ms 이하로 처리된 것이다. |
| p75 | 75번째 백분위수 | 데이터를 작은 값부터 정렬했을 때 75% 위치에 있는 값 | 전체 요청의 75%가 해당 값 이하로 처리되고, 나머지 25%가 해당 값을 초과했음을 의미한다. 일반적인 수준보다 다소 느린 요청을 확인할 때 사용할 수 있다. |
| p90 | 90번째 백분위수 | 데이터를 작은 값부터 정렬했을 때 90% 위치에 있는 값 | 전체 요청의 90%가 해당 값 이하로 처리되고, 나머지 10%가 해당 값을 초과했음을 의미한다. 응답이 느린 구간과 전반적인 성능 저하 여부를 확인할 때 유용하다. |
| p95 | 95번째 백분위수 | 데이터를 작은 값부터 정렬했을 때 95% 위치에 있는 값 | 전체 요청의 95%가 해당 값 이하로 처리되고, 나머지 5%가 해당 값을 초과했음을 의미한다. 대다수 사용자의 응답 경험을 확인하거나 SLO 및 성능 기준을 설정할 때 자주 사용한다. |
| p99 | 99번째 백분위수 | 데이터를 작은 값부터 정렬했을 때 99% 위치에 있는 값 | 전체 요청의 99%가 해당 값 이하로 처리되고, 나머지 1%가 해당 값을 초과했음을 의미한다. 일부 사용자에게 발생하는 극단적인 지연이나 일시적인 성능 문제를 확인할 때 사용한다. |
Datadog 대시보드 구축 시 주의할 점
- Metric이 Count인지 Rate인지 확인해야 한다. (몇몇 Data는 Rate로 반환되고 있었다.)
- Average, Sum, Maximum 등 어떤 집계 방식을 사용하는지도 확인해야 한다.
- Service Tag는 애플리케이션을 구분하고, Host Tag는 실제 서버를 구분하는 데 사용한다.
- No Data는 값이 0인 상태와 다르다. 데이터가 수집되지 않고 있을 가능성도 확인해야 한다.
- 하나의 지표만으로 원인을 판단하지 않고 Metric, Trace, Log를 함께 확인해야 한다.
참고 자료
마치며
- APM은 애플리케이션의 상태를 확인하고 성능 저하와 장애의 원인을 찾기 위한 Tool이다.
- 요청 건수, 응답 시간, 오류율 등의 Metric을 통해 이상 징후를 발견할 수 있고, Trace와 Log를 확인하여 문제가 발생한 요청과 구간을 분석할 수 있다.
- Scouter와 Datadog은 사용 방법에는 차이가 있지만 애플리케이션의 문제를 빠르게 발견하고 추적한다는 목적은 동일하다.
다만, Datadog은 APM 기능뿐만 아니라 Infra, Security 등 다양한 기능도 함께 제공하기 때문에 확실한 이점이 있다.
- APM을 제대로 활용하려면 Tool의 사용법뿐 아니라 WAS, JVM, DB 등 애플리케이션이 동작하는 구조, 운영-모니터링 시 필요한 데이터도 함께 이해해야 한다.
- 마지막으로 개인 프로젝트나 사이드 프로젝트 수준에서는 이런 APM을 사용할 일이 없다. 사용해도 되지만 유의미한 결과를 보긴 힘들것이다. (동접자 수가 그리 많지 않을테니…) 그런 의미로 이번 APM 사용 경험과 모니터링 프로세스를 알 게 돼서 이 경험이 의미가 있다고 본다.